

Resumen ejecutivo:
- Agente de IA autónomo: Sistema de IA que planifica, ejecuta herramientas y toma decisiones en ciclos ReAct sin necesidad de intervención humana constante.
- Super-agente de IA: Entidad continua y multitarea que conserva su contexto durante días o meses y reacciona proactivamente a eventos de su entorno (triggers).
- Arquitectura de dos niveles: Separa un router (coordinador central ligero de larga duración) de múltiples workers (ejecutores especializados en entornos aislados).
- Separación de infraestructura: Aísla el cómputo y estado en la nube mientras ejecuta comandos locales mediante programas ligeros (Bring Your Own Machine – BYOM).
- Caso real de aplicación: Softwares de marketing con IA, como Vilma.ai, aplican este principio utilizando un Cerebro de contexto continuo y más de 15 agentes especializados coordinados por un enrutador central.
- Adopción del mercado: Gartner prevé que el 40 % de las aplicaciones empresariales integrarán agentes de IA para finales de 2026.
Agentes de IA autónomos y super-agentes: qué son, cómo funcionan y qué cambia en el trabajo
Un agente de IA autónomo es un sistema que realiza tareas por sí mismo: diseña un plan, usa herramientas y avanza hasta cumplir un objetivo. Un super-agente es una evolución de ese concepto. Es una entidad continua que conserva su contexto durante días, atiende varias tareas a la vez y reacciona a lo que ocurre en el entorno de trabajo, sin que una persona tenga que abrir una conversación nueva para cada asunto.
Esta guía tiene dos partes. La primera explica la idea sin tecnicismos. La segunda baja al funcionamiento interno, con definiciones de cada término la primera vez que aparece y con explicaciones en lenguaje sencillo después de cada cifra.
Parte 1: La idea en lenguaje sencillo
Del chatbot al agente
Un chatbot responde cuando alguien le escribe. IBM lo describe como un sistema que no tiene herramientas, memoria ni capacidad de planificar, por lo que solo sirve para objetivos de corto plazo y necesita que la persona indique cada paso.
Un agente de IA, en cambio, planifica, consulta fuentes, ejecuta acciones y ajusta su plan según lo que observa. Trabaja en ciclos de pensar, actuar y revisar el resultado, un patrón que IBM llama ReAct.
Aun así, un agente sigue necesitando objetivos y reglas definidos por personas. Su autonomía es operativa, no de propósito.
No todo lo que se vende como agente lo es. Gartner llama agentwashing a presentar como agentes a asistentes que dependen de la intervención humana.
Su modelo de evolución distingue cinco etapas: asistentes dentro de cada aplicación, agentes para tareas específicas, agentes que colaboran dentro de una aplicación, ecosistemas de agentes que cruzan aplicaciones y, finalmente, trabajadores que crean y gobiernan agentes según la necesidad.
Qué es un super-agente
El término lo popularizó el equipo de DeepSeek Harness en una propuesta de arquitectura publicada en X. No es todavía un estándar de la industria, así que conviene leerlo como una propuesta, no como la descripción de productos existentes.
El punto de partida es un problema cotidiano. Hoy, cada tarea con una IA suele vivir en su propia conversación. Si una persona lleva cinco proyectos, debe abrir cinco chats, recordar qué contiene cada uno y revisar su avance por separado.
Según la propuesta de DeepSeek, una persona promedio puede seguir de forma efectiva entre tres y cinco sesiones activas al mismo tiempo.
Por encima de eso, el límite ya no es la inteligencia del modelo, sino la atención humana.
Diseño de un super-agente de IA
Un super-agente busca eliminar esa carga. Su diseño descansa en cuatro cualidades:
- Continuo. La persona le escribe en el canal donde ya trabaja, como un chat de equipo o un comentario en un proyecto de código, y no necesita recordar qué se dijo en otro lugar. Si pide un plan por chat y después pide un cambio en un comentario, el agente entiende la transición.
- Productivo. Atiende varias tareas en paralelo y puede recibir una instrucción nueva antes de terminar la anterior.
- Proactivo. No espera una orden para cada paso. Observa su entorno, actúa cuando detecta algo relevante y permanece en silencio cuando no lo hay.
- Persistente. Sigue activo durante trabajos largos, se conecta a las herramientas reales de la organización y se recupera de fallos sin intervención.
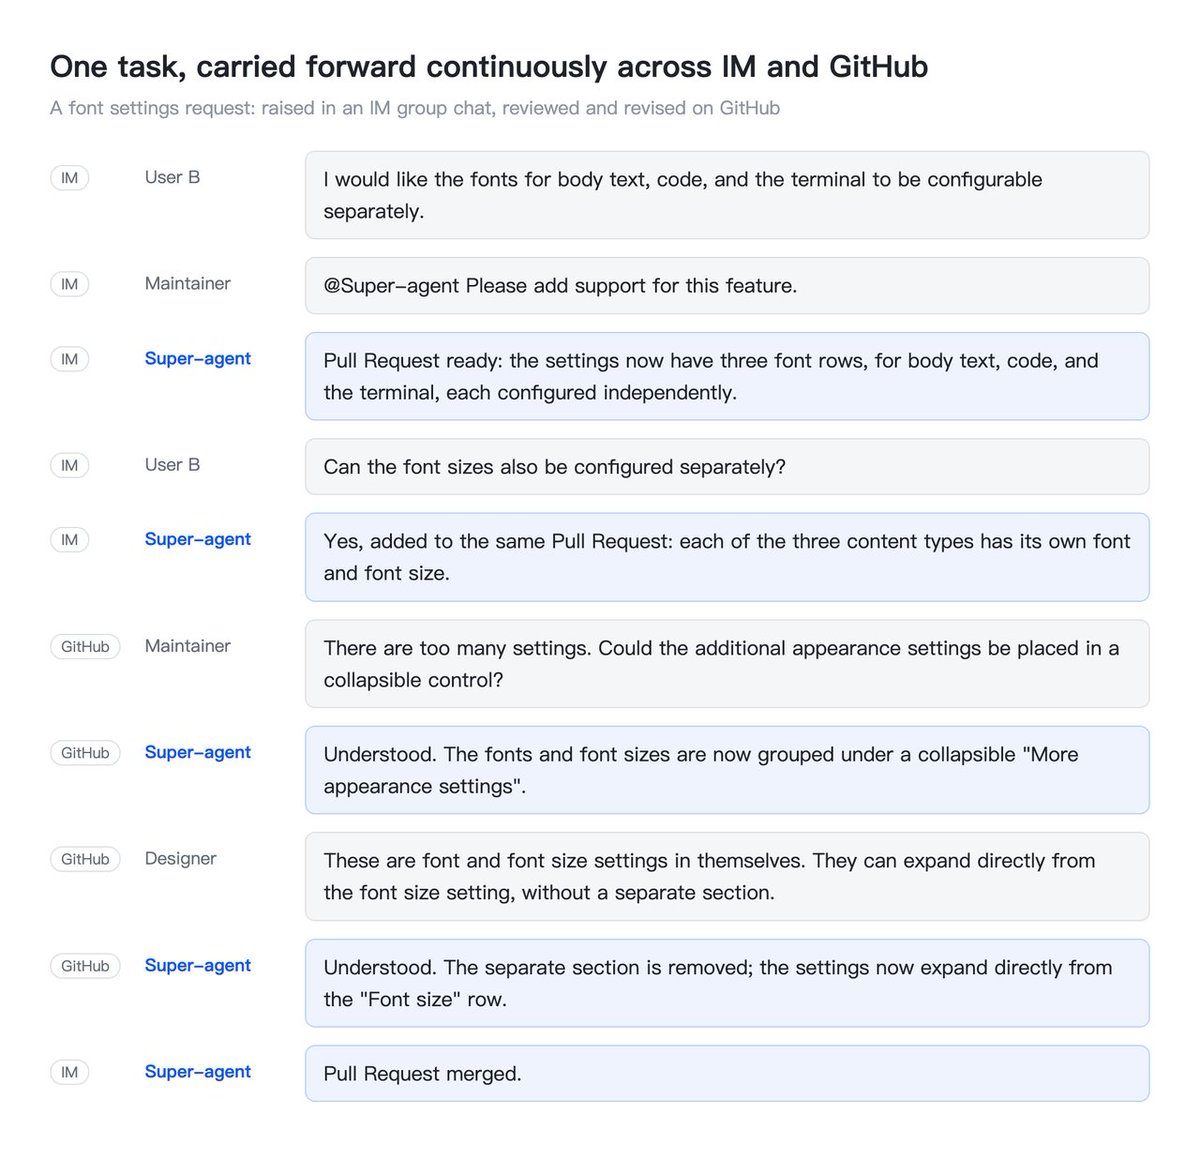
La propuesta sostiene que ningún bucle de razonamiento aislado puede ofrecer las cuatro cualidades a la vez. Deben venir de la arquitectura que lo rodea.
Esa idea coincide con la guía de Google Cloud, que recomienda elegir el patrón de diseño según la carga de trabajo, no solo según el modelo.
Comparativa conceptual de capacidades
| Característica | Chatbot tradicional | Agente de IA autónomo | Super-Agente |
|---|---|---|---|
| Persistencia | Por conversación / chat activo | Limitada a la tarea específica | Continua entre canales (días/meses) |
| Modo de activación | Reactivo (espera texto del usuario) | Por objetivo o instrucción puntual | Proactivo por eventos del entorno (triggers) |
| Paralelismo | Tarea única sincrónica | Secuencial con herramientas | Múltiples tareas asincrónicas en paralelo |
| Gestión de memoria | Dentro de la ventana del chat actual | Limitada al contexto inmediato | Contexto tratado como caché (Inline/Spill) |
Una analogía interesante: la cocina de un restaurante
Piensa en un restaurante con buen servicio. Hay tres roles:
- El mesero atiende a los comensales, toma pedidos y responde preguntas. Es la cara del sistema, la parte que conversa con las personas.
- El expedidor recibe los tickets, decide qué estación prepara cada platillo y lleva el registro de todo lo que está en curso. No cocina.
- Las estaciones preparan cada platillo por separado, con sus propios ingredientes y utensilios, y avisan al expedidor cuando terminan.
El comensal habla con el mesero y no ve la cocina. Así funciona un super-agente: la persona trata con una sola entidad y la complejidad queda adentro.
Cómo sabe cuándo actuar un super-agente de IA
Un agente tradicional solo despierta cuando alguien le escribe. Un super-agente escucha los eventos de su entorno: mensajes de un chat, correos, alertas de calendario, comentarios en código o resultados de pruebas.
La propuesta los llama disparadores, en inglés triggers.
Como casi todo ese flujo es ruido, la propuesta filtra en dos etapas:
- Una regla fija descarta lo irrelevante. Un mensaje en el chat de la oficina que pregunta si alguien quiere café se descarta sin consumir ningún modelo.
- Un modelo decide sobre lo que sobrevive. Si un cliente escribe que su factura trae un cobro duplicado, la regla lo deja pasar y el modelo evalúa si corresponde actuar, según las instrucciones que la empresa haya definido.
Esas instrucciones funcionan como interruptores. Una política puede activarse, desactivarse o añadirse en cualquier momento, sin reprogramar el sistema.
Trabajar sin estar presente
Imagina que desde el celular pides al agente un resumen de la reunión de mañana y una revisión de conflictos en el calendario. Antes de abordar, tu laptop se apaga.
En un agente tradicional, el trabajo se detiene con el equipo. En un super-agente, el “cerebro” del sistema vive en servidores en la nube y sigue activo.
Cuando enciendes la laptop, un pequeño programa local se conecta y permite que el agente use los archivos de tu equipo para terminar lo pendiente.
Cómo habla con las personas
Un modelo tradicional funciona como un walkie-talkie: tú hablas, esperas mientras procesa y solo después puedes decir algo más. Un super-agente se parece más a un teléfono: puedes enviar correcciones mientras él trabaja en segundo plano.
El tono también cambia según el canal. En mensajería instantánea, la respuesta es breve; la propuesta menciona un límite de unas 100 palabras por respuesta. En correo o en GitHub, el agente entrega informes estructurados, con contexto, pasos y resultados.
Por qué no se queda atascado
A veces un agente no falla de forma visible: sigue activo, pero repite el mismo razonamiento o se aleja del objetivo. La propuesta incluye un Watchdog (vigilante), un proceso de control externo que funciona como un supervisor de obra.
No solo revisa que el sistema siga encendido, también evalúa si el avance es real, atiende errores de conexión y permite que un responsable pregunte en lenguaje natural por qué falló una tarea.
Parte 2: Cómo funciona por dentro
Un marco que viene de la informática clásica
El problema de coordinar muchas tareas concurrentes con memoria limitada no es nuevo.
La propuesta de DeepSeek aplica principios clásicos de sistemas operativos y bases de datos, como separar componentes, usar rutas rápidas para lo frecuente y rutas lentas para lo excepcional, o tratar la memoria como una caché.
Por eso no se presenta como una teoría nueva, sino como una arquitectura que reutiliza ideas probadas.
Anthropic sigue una lógica parecida. En su descripción de un servicio gestionado, compara su enfoque con los sistemas operativos: estos virtualizaron el hardware en abstracciones como proceso o archivo, lo bastante generales para durar más que cualquier equipo concreto.
Un agente, según Anthropic, debe apoyarse en interfaces estables que sobrevivan a cambios en su implementación.
Por qué añadir conectores no basta
Una tentación frecuente es tomar un agente existente y añadirle conectores, interfaces de línea de comandos o acceso a mensajería. Esto permite recibir mensajes externos, pero no resuelve el problema de fondo.
El agente sigue ejecutándose en una sola sesión sincrónica, que se bloquea con operaciones largas, mezcla el contexto de tareas distintas y se detiene cuando el equipo local se desconecta.
La propuesta concluye que la continuidad requiere cambiar la arquitectura, no solo ampliar las entradas.
Arquitectura de dos niveles
La propuesta resuelve un dilema. Si todos los eventos llegan a una sola sesión, el contexto es completo, pero la sesión avanza paso a paso y los detalles de distintos proyectos se mezclan.
Si cada evento abre una sesión nueva, hay concurrencia, pero los resultados quedan desconectados.
La solución separa dos capas:
- Capa de enrutamiento (router). Una sesión de larga duración que atiende a las personas, coordina el trabajo y guarda la memoria compartida. No ejecuta tareas. Su carga es más ligera de lo esperado, y según la propuesta, un modelo más compacto suele bastar.
- Capa de trabajadores (workers). Sesiones con contexto aislado, herramientas completas y una única tarea asignada. Usan los modelos más capaces porque determinan la calidad del resultado. Nunca hablan con las personas; reportan su estado al router, que es quien responde.
En su artículo, DeepSeek Harness aclara que un trabajador puede, a su vez, crear subagentes o ser un equipo de agentes. Esto es transparente para el router, de modo que la arquitectura puede repetirse a distintos niveles.
La diferencia con un equipo de agentes convencionales está en el papel del líder. En un equipo tradicional, el líder descompone cada tarea y coordina a los miembros de forma constante, lo que exige mucho razonamiento.
En un super-agente, el router solo asigna trabajo y observa las relaciones entre tareas.
Según la postura de DeepSeek, un equipo de agentes también puede funcionar como arquitectura de dos niveles si sus instrucciones impiden que la sesión principal ejecute trabajo.
Procesamiento por lotes
Los eventos que llegan mientras el router procesa una respuesta no se pierden ni esperan en fila uno por uno. Se acumulan y entran juntos en la siguiente llamada al modelo.
A este mecanismo se le llama procesamiento por lotes o batching.
Como el router recibe entradas largas y produce salidas cortas, agregar más eventos a la misma llamada cuesta poco.
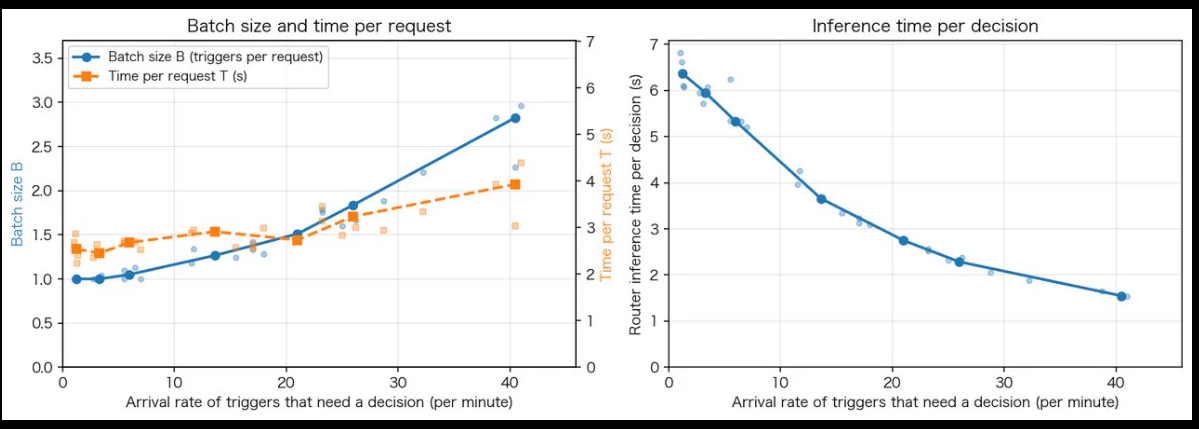
Un experimento sintético midió el efecto con un router que usaba un modelo real y trabajadores simulados. Al subir la llegada de eventos de 1 a 40 por minuto, el tamaño promedio de lote pasó de 1.0 a 2.8.
El tiempo por petición subió de 2.5 a 3.9 segundos, mientras que el tiempo de inferencia por decisión, descontando el lote, bajó de 6.4 a 1.6 segundos. Los autores aclaran que son resultados indicativos.
Qué significa en la práctica
Imagina a una recepcionista que atiende llamadas. Si entran tres llamadas seguidas mientras ella anota la primera, no le conviene colgar y atender cada una por separado: es más eficiente que escuche las tres juntas, anote todo de una vez y responda en un solo momento.
Eso es lo que hace el router. Cuando llega poco trabajo, cada evento se atiende de inmediato. Cuando llega una avalancha, el sistema la absorbe agrupando los pendientes, y el costo promedio por evento baja.
En los números, cada decisión necesitó en promedio 6.4 segundos cuando el tráfico era bajo y 1.6 segundos cuando era alto, aunque cada respuesta individual tardó algo más.
El sistema procesa más eventos por unidad de tiempo sin volverse lento para cada persona. Para una empresa, la conclusión práctica es que una sola sesión central puede aguantar picos de actividad sin necesidad de dividirla de inmediato.
Comparativa de diseños
La propuesta compara cuatro diseños en un escenario sintético de unos 300 mensajes, con cerca de 20 peticiones de trabajo y cinco ejecuciones por diseño. Las cifras, según DeepSeek Harness, son estas:
| Diseño | Finalización p50 / p95 (min) | Tokens de caché leídos por ejecución |
|---|---|---|
| Super-agente | 12.4 / 15.7 | 23.2 millones |
| Super-agente sin paso directo | 12.6 / 15.5 | 31.8 millones |
| Sesión única con subagente, prompt neutro | 20.4 / 29.5 | 6.1 millones |
| Sesión única con subagente, prompt de delegación | 13.8 / 29.0 | 10.8 millones |
Para leer bien la tabla hay que tener en cuenta algunos matices. Las herramientas se simularon con funciones que solo consumen tiempo, así que el estudio mide coordinación y planificación, no la capacidad de programar.
Además, los tiempos se escalaron y el entorno era simplificado. Los autores presentan los resultados como una señal, no como un benchmark general.
Qué significa en la práctica
Las columnas responden a dos preguntas. La primera es cuánto tarda el sistema en terminar un encargo. El p50 es el caso típico: la mitad de las tareas termina antes de ese tiempo y la otra mitad después.
El p95 es el caso lento: 95 de cada 100 tareas terminan antes. Un super-agente típico termina en unos 12 minutos y, en los casos lentos, en unos 16.
Una sesión única con prompt neutro tarda unos 20 minutos en el caso típico y casi 30 en el lento. Según los autores, la diferencia se debe sobre todo a que la sesión única hizo casi todo el trabajo ella misma y se distraía con cada mensaje nuevo, en lugar de delegarlo.
La segunda columna mide cuánto contexto reutilizado consume el sistema. El super-agente gasta más, porque mantiene varias sesiones independientes funcionando a la vez.
Es un intercambio: se paga más cómputo para ganar velocidad y estabilidad. La versión sin paso directo, que es el atajo que evita revisar mensajes ya asignados a un trabajador, consume alrededor de 37% más tokens sin terminar las tareas más rápido.
Es decir, el atajo no acelera el trabajo, pero sí ahorra recursos.
Hilos y suscripciones
Cuando un evento supera el filtro, el router asigna un trabajador. A partir de ahí, la propuesta usa el concepto de hilo: una secuencia de eventos relacionados, como una discusión en un Pull Request, un tema de chat o una cadena de correo.
El trabajador se suscribe al hilo. Los eventos siguientes del mismo hilo llegan directamente a él, sin pasar por el router, lo que descarga al nodo central. Si llega un evento que no corresponde a su tarea, el trabajador lo devuelve al router.
Las suscripciones son de muchos a muchos: varios trabajadores pueden seguir un mismo hilo y ver los movimientos de los demás, lo que les permite resolver conflictos sin comunicación directa.
El router sigue viendo todos los eventos para mantener el estado global. Solo se encarga de decidir cuando llega algo nuevo, sin trabajador asignado.
Un ejemplo de la propuesta: alguien reporta un error en un chat público sin mencionar al agente. El sistema lo identifica como un fallo concreto, intenta reproducirlo en segundo plano y solo publica una corrección cuando confirma el error y encuentra una solución limpia. Si no lo logra, guarda silencio.
La propuesta de DeepSeek lo llama ejecución especulativa, un préstamo de los sistemas de cómputo: se hace algo por anticipado y se descarta si no sirve.
Contexto: la ventana como caché
La ventana de contexto de un modelo es un espacio limitado. Si se le llena de información, su atención se diluye. Si se le da muy poca, debe consultar herramientas una y otra vez. La propuesta lo trata como una caché y usa dos operaciones:
- Inline: colocar en la ventana lo que probablemente se necesitará pronto, como identificadores de objetos relacionados, el inicio de un mensaje o comentarios cercanos.
- Spill: dejar fuera de la ventana lo extenso o secundario y conservar solo un resumen o una referencia, que el modelo puede consultar si lo requiere.
Cada objeto del sistema (evento, hilo, sesión de trabajo) tiene un identificador, y las respuestas de herramientas incluyen los identificadores de los objetos vecinos.
Así se forma un grafo de referencias que el modelo recorre paso a paso, lo que la propuesta llama Chain of Recall. Por ejemplo, desde un mensaje actual puede llegar al hilo de código relacionado, de ahí al trabajador que lo atiende y de ahí a otra revisión vinculada.
Anthropic describe una idea afín: el registro de la sesión vive fuera de la ventana de contexto, y el sistema puede consultar fragmentos de ese registro sin depender de lo que cabe en la ventana.
Según su artículo, la sesión sirve como un objeto de contexto consultable, con reglas de transformación que el arnés puede aplicar antes de pasar la información al modelo.
Un límite que la propuesta reconoce: a lo largo de meses, la memoria global se convierte en el cuello de botella principal, y aún no tiene una solución definida.
Qué significa en la práctica
Piensa en un escritorio de trabajo con espacio limitado. Lo que usas todos los días está a la mano; los expedientes de hace meses están guardados en un archivo, con una etiqueta que indica dónde buscarlos.
No tienes que tener todo el archivo sobre la mesa para trabajar, pero sí sabes qué buscar y a dónde ir cuando lo necesitas. Así funciona el sistema: lo inmediato entra en la ventana del modelo, lo demás queda guardado y se consulta solo cuando hace falta.
El reto aparece cuando el trabajo dura meses.
El archivo crece tanto que encontrar lo importante se vuelve lento y costoso, y la propuesta reconoce que esa memoria de largo plazo todavía no tiene una solución definida.
En otras palabras, el sistema puede recordar lo reciente con eficacia, pero mantener un historial completo y útil durante un año sigue siendo un problema abierto.
Interacción asíncrona
En un bucle clásico, cuando el modelo ejecuta una herramienta de forma síncrona, la conversación queda bloqueada hasta que termina. La propuesta sustituye esa llamada por dos operaciones asíncronas: start(), que confirma de inmediato que la tarea comenzó, y stop(), que permite cancelar una ejecución que tarda demasiado.
Cuando la tarea termina, su resultado llega a la sesión como un evento nuevo. Los autores indican que DeepSeek Harness ya implementa este mecanismo, aunque no está activado por defecto.
Separación de cómputo, estado y entorno
Un agente local típico ata en un solo equipo tres cosas: el bucle que ejecuta al agente, el estado de la sesión y el entorno de trabajo, como repositorios, dependencias y herramientas. Si el equipo se apaga, el agente se detiene.
La propuesta separa estos elementos en dos pasos:
- Cómputo y estado en la nube. El bucle del agente corre en contenedores elásticos sin estado, y las sesiones se guardan en una base de datos persistente. Si un contenedor falla, se reemplaza. Si un equipo se apaga, el agente sigue.
- Cómputo y entorno en el equipo de la persona. En lugar de migrar entornos complejos, la máquina de la persona ejecuta un programa ligero, llamado demonio, que solo recibe comandos y devuelve resultados, sin guardar estado. Esto permite usar cambios no confirmados, credenciales privadas y servicios internos sin copiarlos. La propuesta lo llama BYOM, Bring Your Own Machine (trae tu propia máquina).
Anthropic usa una metáfora de infraestructura para explicar la misma idea: la distinción entre mascotas y ganado. Una mascota es un servidor único, con nombre, al que hay que cuidar si falla. Un animal de ganado es intercambiable.
En su primera arquitectura, Anthropic puso todo el agente en un solo contenedor, y ese contenedor se convirtió en una mascota: si fallaba, la sesión se perdía. Al separar el cerebro de las manos, el contenedor pasó a ser ganado.
Qué significa la cifra de latencia
Según la misma fuente, este diseño mejoró la latencia de su servicio gestionado: la mediana del tiempo hasta el primer token bajó alrededor de 60% y el percentil 95, más de 90%.
El tiempo hasta el primer token es lo que tarda el sistema en empezar a responder después de recibir una petición. Una mejora de 60% en la mediana significa que la mayoría de las respuestas empiezan a llegar en menos de la mitad del tiempo anterior.
La mejora en el percentil 95 indica que los casos lentos, los que más frustran, se volvieron mucho más raros. Para el usuario, la diferencia se siente como una respuesta que aparece casi de inmediato en lugar de una espera incómoda.
La diferencia de escenario importa: Anthropic describe un servicio en su propia infraestructura, mientras que la propuesta de DeepSeek Harness se enfoca en equipos personales y de desarrollo.
Sesión, proyecto y producto
Una de las tesis más importantes de la propuesta es que, en los diseños actuales, la sesión cumple dos funciones a la vez: maneja el contexto del modelo y funciona como unidad de gestión de proyecto para la persona.
Al separarlas, la gestión del trabajo deja de depender de los límites técnicos de cada sesión y se convierte en una decisión de producto.
Los autores sostienen que las sesiones deben ser un detalle interno del sistema, no una carga mental para quien lo usa.
Un caso para un público amplio
Quien trabaje en una aplicación de chat personal puede beneficiarse de la misma lógica. La conversación puede seguir siendo una sola, mientras el sistema abre un trabajador por cada tema y redacta respuestas en paralelo.
Desde fuera, la persona ve un único interlocutor coherente.
Watchdog y fallos transitorios
El Watchdog es un proceso externo, programado con eventos y alimentado por un modelo, que actúa en dos frentes.
Resuelve fallos de infraestructura, como errores de API o de restauración de estado, y vuelve a intentar los fallos externos transitorios hasta que se resuelven.
También evalúa si cada trabajador avanza de forma sustantiva o se ha desviado de su objetivo.
Como el Watchdog es en sí mismo un agente con herramientas, una persona responsable puede preguntarle en lenguaje natural por qué falló algo.
También puede pedirle que ajuste el comportamiento del sistema mientras funciona, por ejemplo añadiendo o quitando instrucciones o reglas de disparo.
Cómo se configura un agente en la práctica
Los conceptos anteriores se traducen en un proceso concreto. Vilma Núñez, fundadora del Grupo Convierte Más y cofundadora de Vilma.ai, el primer software de marketing con IA en español, ha compartido cómo se construye un agente día a día.
Sus pasos ayudan a entender por qué un agente produce resultados útiles o genéricos.
Primero, el Cerebro
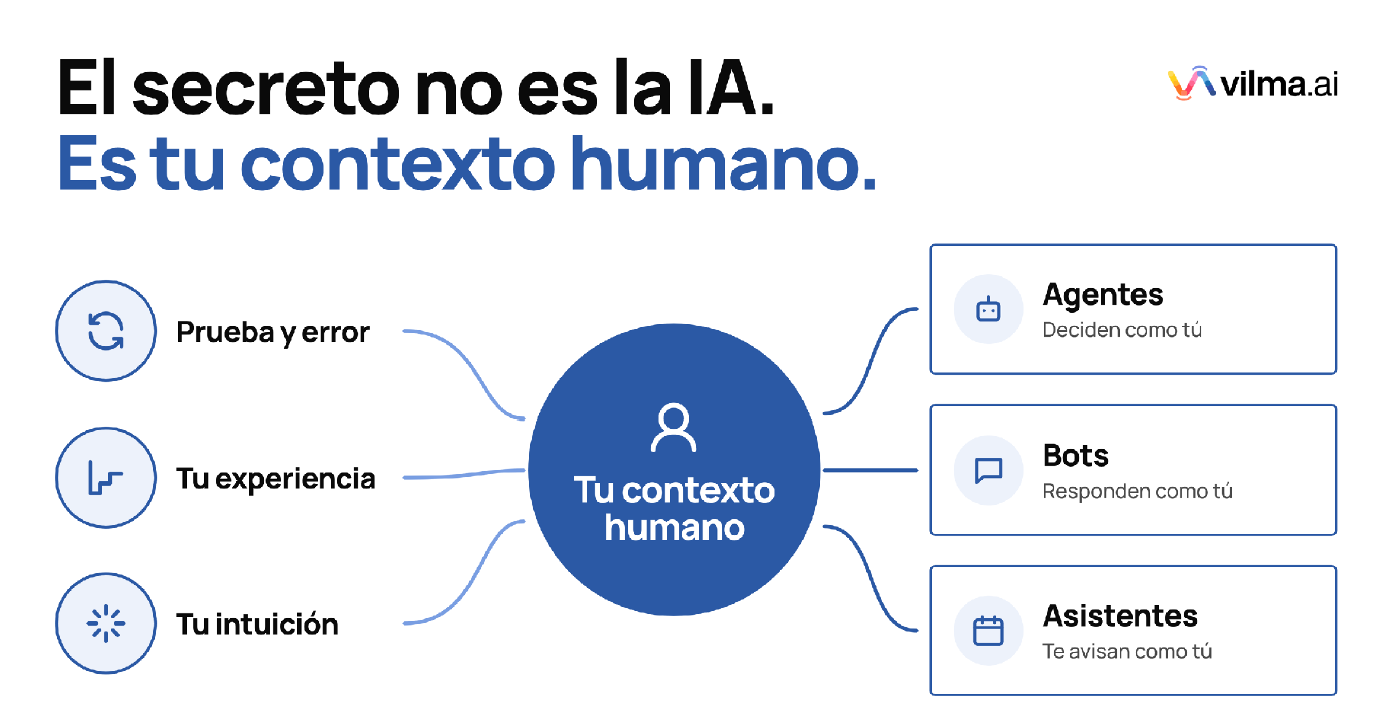
Ella explica que un agente funciona como una versión de la IA a la que se le asigna un rol concreto, y ese rol necesita conocer el negocio.
Por eso el primer paso es cargar en el sistema la información de la empresa: tono, propuesta de valor, buyer personas, productos, ofertas, catálogo y objetivos.
Sin ese contexto, el agente no puede personalizar imágenes, carruseles o contenidos.
Insiste en que el Cerebro es un proyecto vivo. Los precios cambian, el portafolio se ajusta y las empresas evolucionan de un año a otro. Por eso recomienda revisar los documentos una vez al mes, dedicando una hora a corregir lo desactualizado.
También propone pedir al propio agente que señale qué información le falta, porque un Cerebro bien configurado puede indicar los vacíos antes de que aparezcan en un resultado equivocado.
Pero siempre insiste en que lo más crucial de este proceso es no comprometer tu criterio humano.
Después, las habilidades
En palabras de Vilma Núñez, una habilidad, o skill, es un archivo con un nombre y una descripción que indica cuándo usarlo. Por ejemplo, “resumir una llamada de venta y proponer el siguiente paso con el cliente”.
En ese archivo se define el rol del agente, los pasos del trabajo, la plantilla del resultado y ejemplos de lo que está bien y de lo que está mal.
Por ejemplo, explica que para resumir una llamada de venta, el agente primero lee la transcripción y el catálogo de ofertas. Luego extrae lo que el cliente dijo sobre el presupuesto, quién decide, la necesidad y el plazo.
Después anota los objetivos con las palabras del propio cliente y entrega el resultado en la plantilla definida.
Vilma señala que el error más común es querer que la IA haga el trabajo sin que la persona haya definido antes cómo quiere que se haga. Por eso recomienda discutir el paso a paso con la herramienta hasta tenerlo claro.
Agrega que una habilidad aislada es un procedimiento. Cuando se encadena con otras y se ejecuta por eventos, forma parte de un agente.

Conectores y permisos
Los conectores son las herramientas a las que el agente tiene acceso, como el correo, el calendario, una hoja de cálculo o una red social.
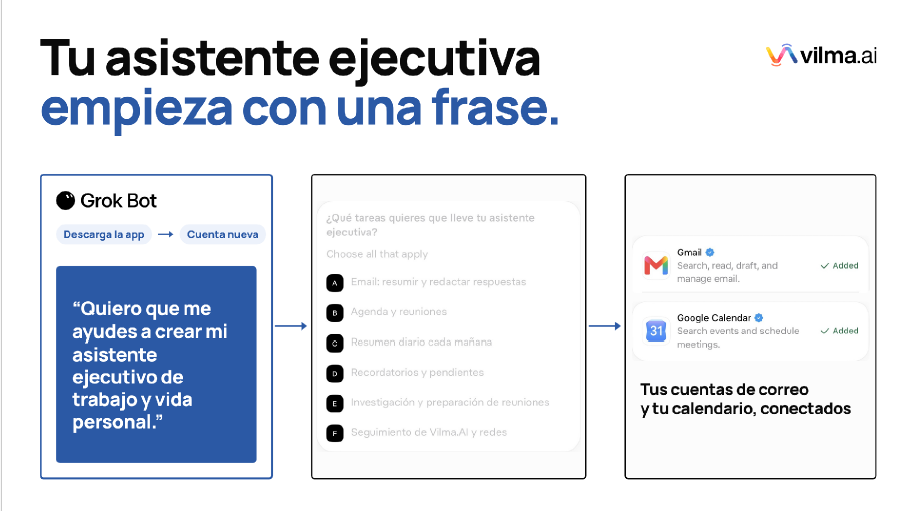
Cada conector puede tener acceso de lectura o de escritura. Según Vilma, la lectura puede concederse con más facilidad, pero la escritura, que permite crear archivos, enviar mensajes o publicar, debe supervisarse.
Una regla práctica es que cualquier habilidad que envíe un correo genere un borrador, y que nadie lo envíe sin aprobación.

Vilma, cofundadora de Vilma.ai, relata un caso que ilustra el riesgo: una IA interpretó mal un dato de vuelos, pues los trayectos nocturnos de Miami a Europa llegan al día siguiente, y el error casi provocó una pérdida económica.
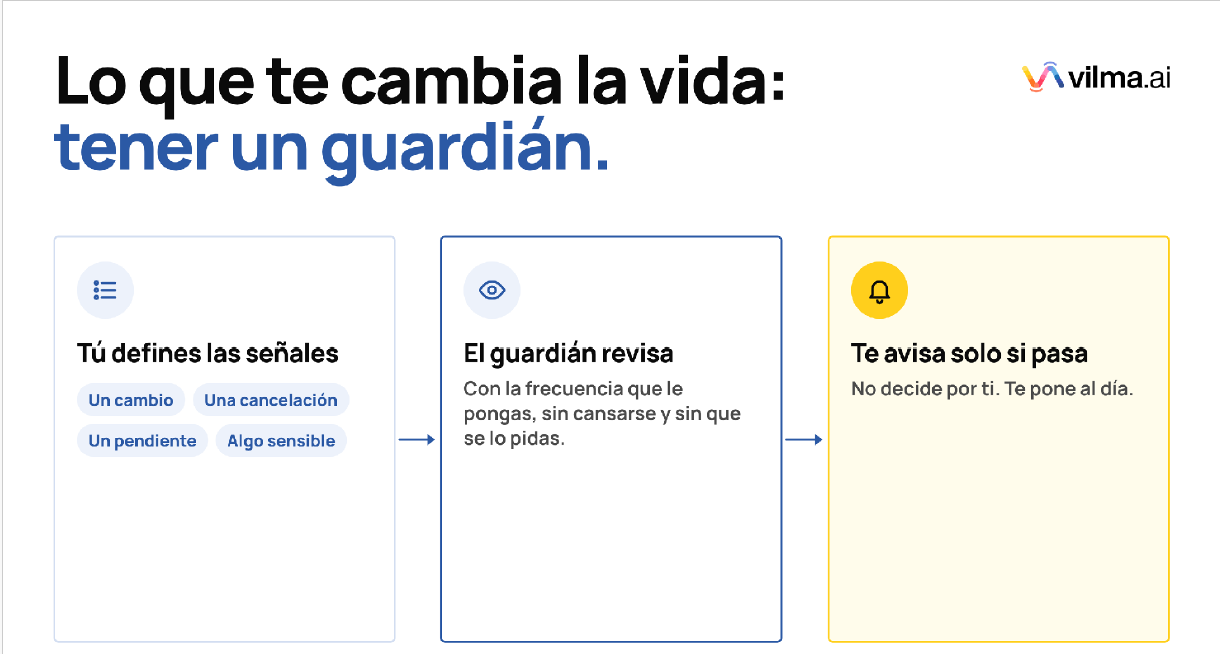
Agrega con énfasis que, es por eso que cada habilidad y cada agente de IA debe tener un guardián y que tú, como humano debes declarar qué puede hacer, qué requiere aprobación y cómo verifica sus fuentes.
De la habilidad al flujo
Cuando varias habilidades trabajan juntas en orden, se forma un flujo.
Vilma explica que, por ejemplo, para preparar una campaña de Black Friday, un flujo puede revisar el Instagram de la marca, identificar dudas y objeciones de la audiencia, analizar a la competencia, redactar briefs y proponer las secuencias de correo para clientes y para quienes aún no conocen la marca.
Insiste en que un flujo no sustituye el criterio humano. Ejecuta paso a paso un trabajo que antes podía tomar días y deja en manos de la persona las decisiones que requieren juicio.
Añade que algunos flujos se repiten cada semana, como el informe de anuncios o el calendario de contenidos. Otros se usan una sola vez, como el plan de lanzamiento de un producto. Y algunos se programan para correr solos, como una alerta diaria o un resumen de la mañana.
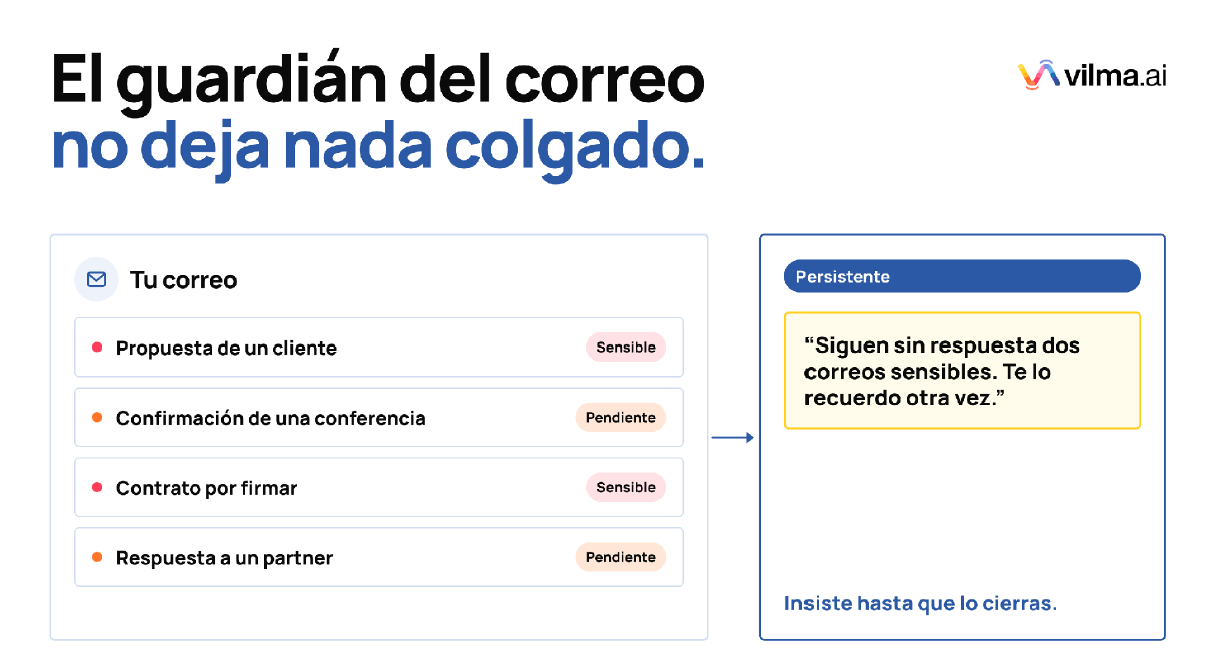
Uno de esos flujos automáticos es el guardián.
Revisa un calendario cada cierto tiempo y avisa solo cuando cambia algo que la persona definió como sensible: una cancelación, un cliente que lleva días sin respuesta o un cambio de última hora. El sistema revisa, y la persona decide qué hacer.
Seguridad, privacidad y gobierno
Riesgos de la arquitectura
Un super-agente recibe entradas de más fuentes y tiene acceso a más entornos, por lo que amplía la superficie de riesgo. La propuesta identifica dos problemas principales:
- Si un ataque de inyección de instrucciones o una intrusión compromete el bucle del agente en la nube, cada equipo conectado podría quedar expuesto. El diseño asume confianza mutua entre la nube y los equipos, y esa confianza es el punto más sensible.
- Las credenciales pueden filtrarse aunque la nube no se vea comprometida, si llegan al contexto del modelo y este las expone durante una ejecución normal.
Anthropic describe una mitigación concreta: que el entorno de ejecución nunca tenga acceso directo a los tokens.
Según su artículo, las credenciales de Git se usan para clonar el repositorio al inicializar el entorno, y las herramientas externas pasan por un proxy que obtiene las credenciales de una bóveda fuera del entorno.
El arnés, que es el programa que coordina al modelo, nunca conoce los secretos.
Riesgos operativos de los agentes de IA autónomos y buenas prácticas
IBM identifica riesgos adicionales: los sistemas multiagente creados sobre los mismos modelos base pueden fallar de forma conjunta, los bucles de retroalimentación pueden consumir recursos sin producir resultados y la integración con sistemas de clientes sin medidas de seguridad puede exponer datos sensibles.
Sus buenas prácticas incluyen mantener un registro de las acciones del agente, permitir que una persona lo interrumpa de forma controlada y exigir aprobación humana antes de acciones de alto impacto, como envíos masivos de correos o transacciones financieras.
Gobierno: qué comparte y qué aísla cada instancia
A medida que el uso crece de personas individuales a equipos y organizaciones, decidir cómo desplegar los super-agentes equivale a decidir qué contexto se comparte y cuál se aísla.
Las áreas que necesitan información compartida pueden usar una misma instancia, y las que requieren aislamiento, una propia.
Cuando dos instancias necesitan colaborar, la propuesta llama a esa comunicación A2A (agente a agente), en sentido general y no como un protocolo concreto.
Todavía falta definir cómo colaboran agentes que no comparten contexto y representan permisos distintos.
Preguntas abiertas
La propuesta reconoce cinco frentes sin resolver:
- Escalar el router. Falta definir cuándo dividirlo en varias partes y cómo se reparte la memoria entre ellas. Los autores prefieren no fragmentarlo pronto, porque cada división reduce el contexto compartido.
- Memoria a largo plazo. Funciona bien para tareas recientes, pero a lo largo de meses es el cuello de botella principal.
- Interacción sin sesiones visibles. Las personas podrían trabajar en interfaces propias de cada dominio, como incidencias de GitHub, sin ver nunca una conversación. Durante la transición, muchas tareas seguirán necesitando intervención humana a mitad de camino.
- Colaboración entre agentes. Definir protocolos seguros para agentes con permisos distintos y sin contexto común.
- Seguridad y privacidad. Garantizar el uso seguro de credenciales cuando el cómputo está en la nube y recibe eventos de fuentes no verificadas.
La propuesta también plantea una dirección de investigación: entrenar modelos específicos para las tareas del router, como juzgar eventos, despachar en lotes o recuperar contexto. Es una posibilidad, no un resultado.
Lo que anticipa el mercado sobre los agentes de IA autónomos
Gartner estima que, a finales de 2026, hasta 40% de las aplicaciones empresariales incluirá agentes integrados para tareas específicas, frente a menos de 5% en 2025.
Para 2027, prevé que un tercio de las implementaciones de IA agéntica combine agentes con habilidades distintas para tareas complejas. Y para 2028, estima que una parte de las experiencias de usuario se mueva desde aplicaciones nativas hacia interfaces agénticas.
Además, para 2029, anticipa que al menos la mitad de los trabajadores del conocimiento necesitará habilidades para crear o gobernar agentes. Gartner
El equipo de DeepSeek Harness, por su parte, anticipa que los agentes personales y los de desarrollo de software convergerán hacia arquitecturas parecidas, porque responden a los mismos problemas de fondo. Es una predicción de los autores, no un hecho.
Cómo lo aplica Vilma.ai
Vilma.ai es el primer software de marketing con inteligencia artificial del mercado hispano.
Su arquitectura es una aplicación concreta de las ideas de esta guía: un contexto persistente, tareas encadenadas y coordinación entre agentes especializados.
El punto de partida es el Cerebro, un conjunto de documentos clave del negocio: tono y propuesta de valor, buyer personas, productos, ofertas y catálogo, y objetivos.
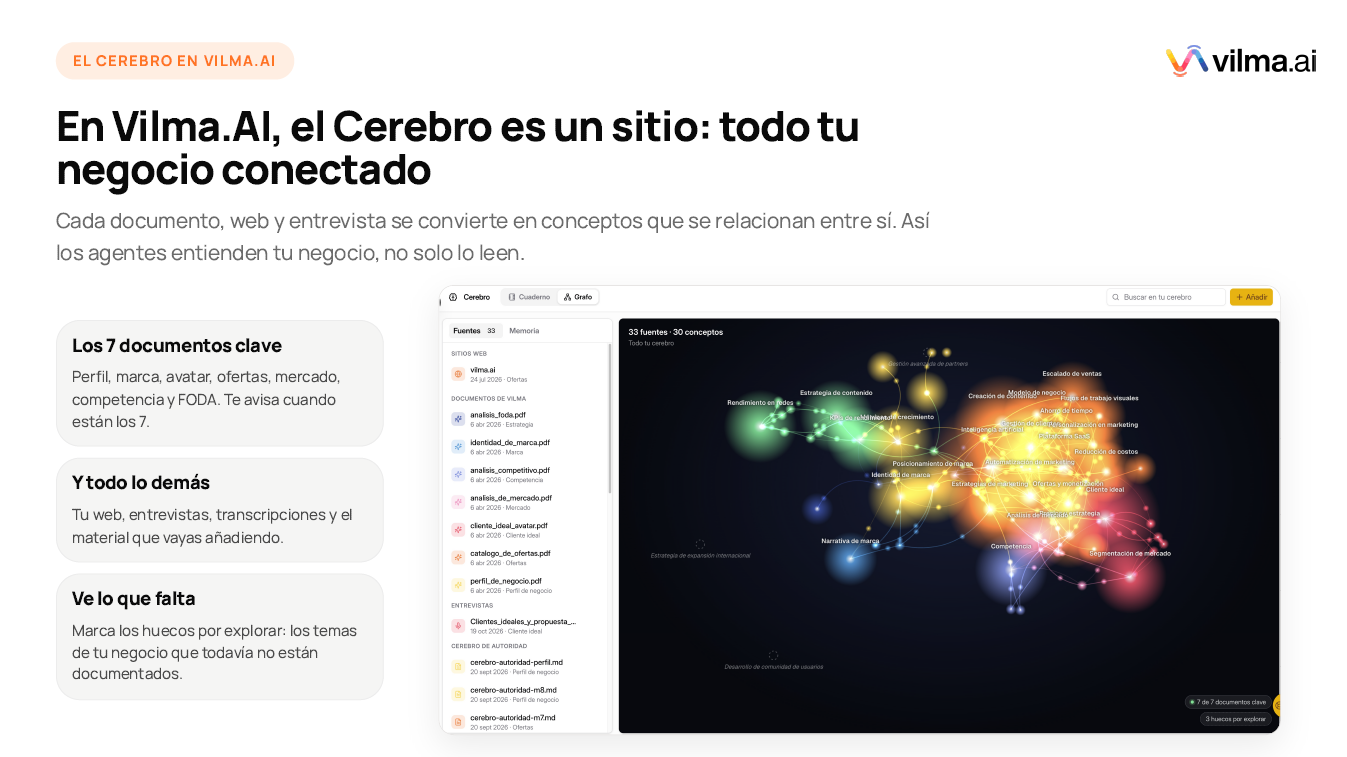
Vilma.ai aprende la marca, el tono y los objetivos a partir de esos documentos, y mientras más se usa, más conoce el negocio. Por eso sus tareas y creatividades salen personalizadas desde el inicio y no como respuestas genéricas.
Este principio es el que la guía describe como contexto continuo: el sistema no depende de que la persona recuerde qué información dio en cada conversación.
Sobre ese contexto, Vilma.ai organiza el trabajo en workflows inteligentes, que conectan tareas y permiten pasar de una idea a campañas listas en minutos.
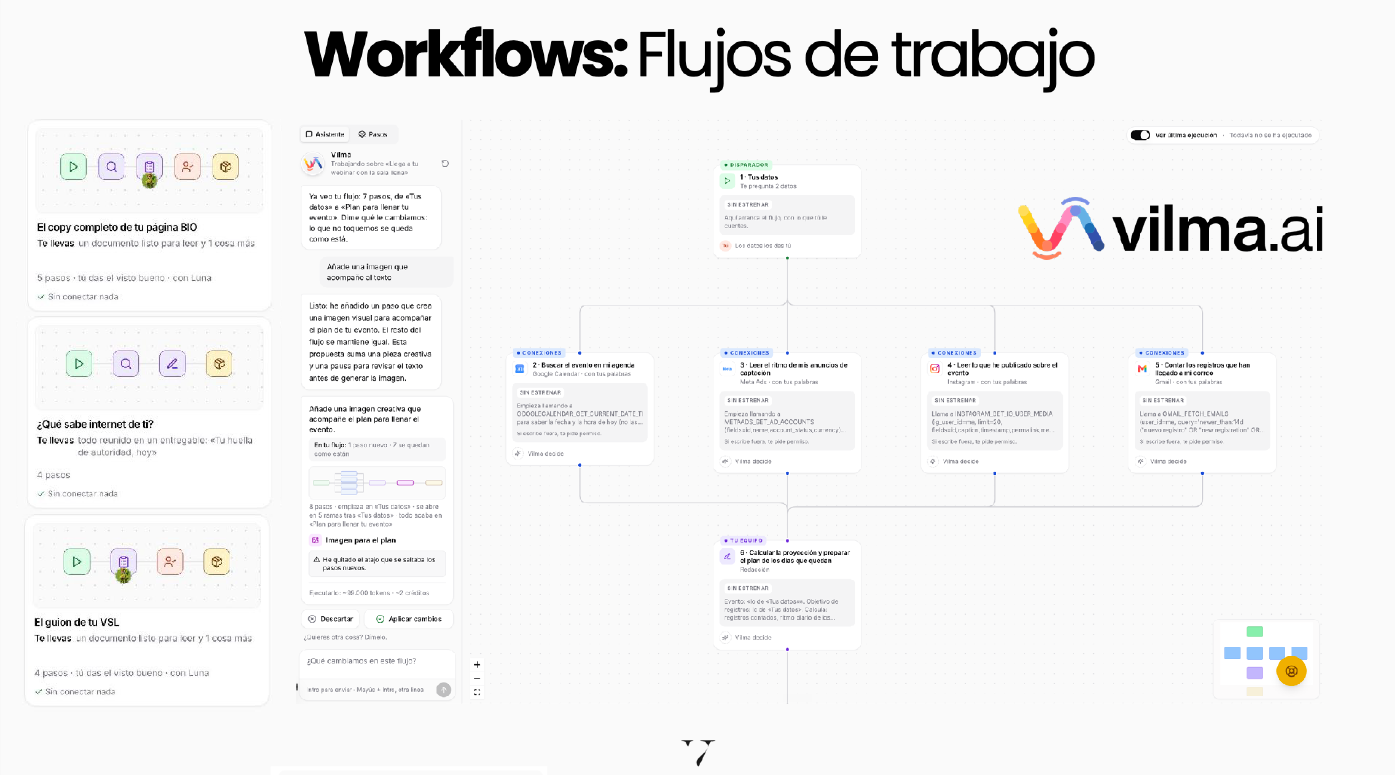
También cuenta con una memoria que recuerda lo conversado y se vuelve más útil con cada interacción. Ambos elementos responden al problema central del super-agente: que el trabajo no se pierda entre conversaciones.
El sistema trabaja con más de quince agentes especializados, entre ellos estrategia, copy, contenido y SEO, redes, paid media, CRM, análisis de datos y gestión de proyectos.
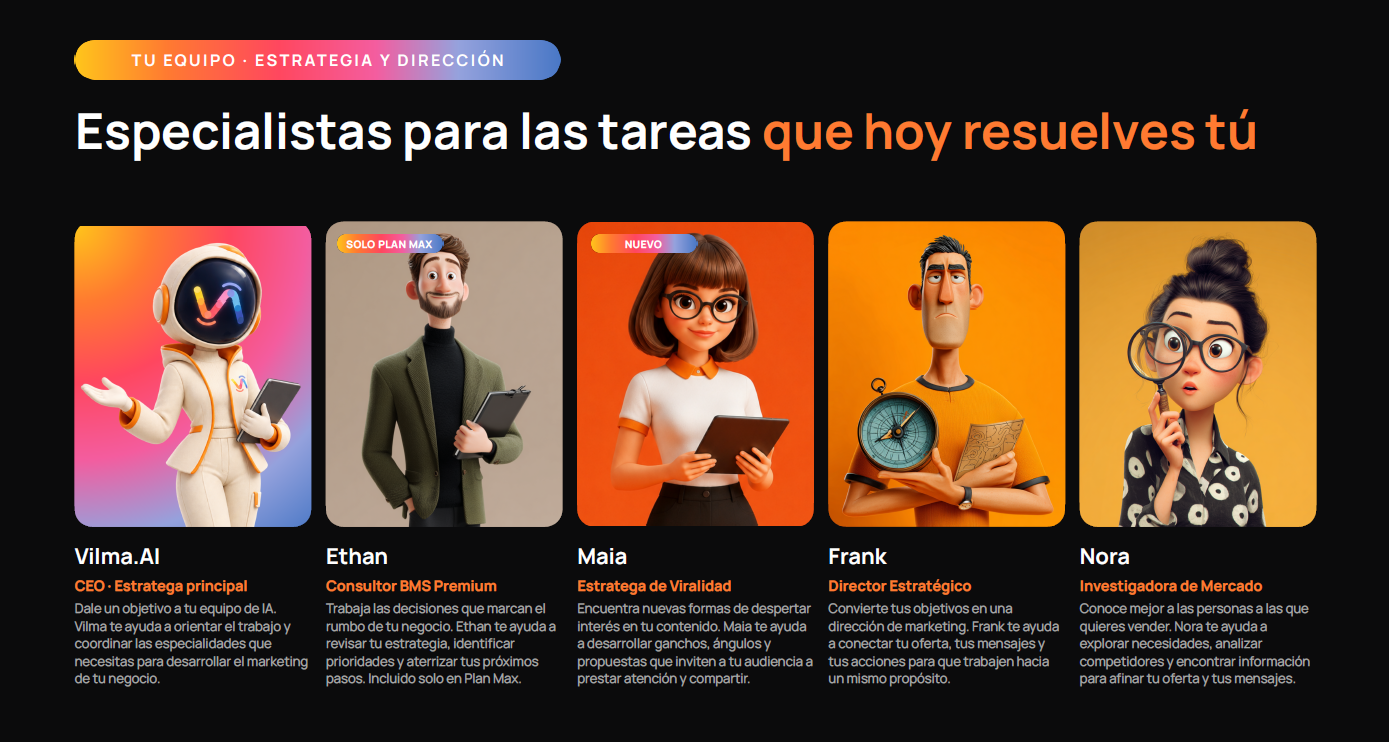
Todos están coordinados por un agente principal, Vilma, que decide cómo se reparte cada encargo. Esa coordinación es la misma lógica de enrutador y trabajadores que describe la propuesta de DeepSeek Harness, aunque la implementación interna de Vilma.ai no es pública y la comparación debe leerse como conceptual.
Las creatividades son otra pieza del flujo.
Desde el chat se generan imágenes, carruseles, anuncios para Meta y Google, e infografías, todos alineados con la identidad visual de la marca, sin necesidad de diseñador ni herramientas externas.
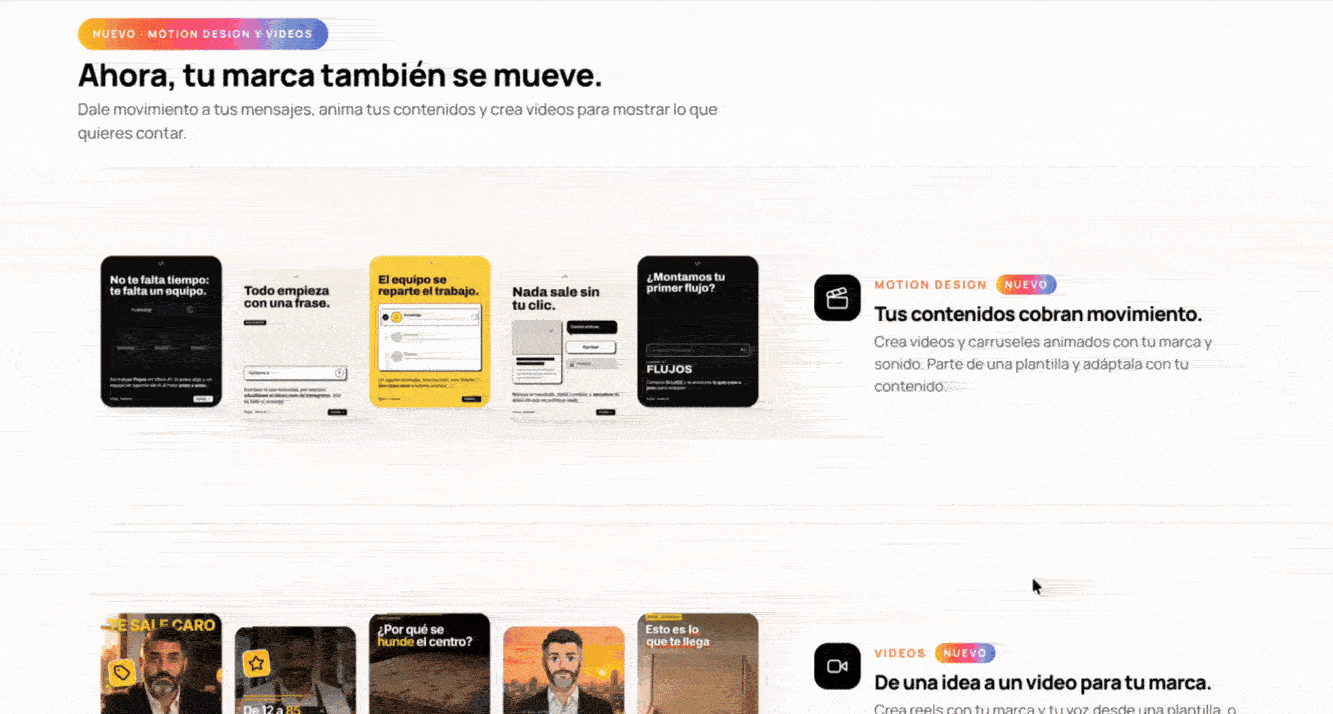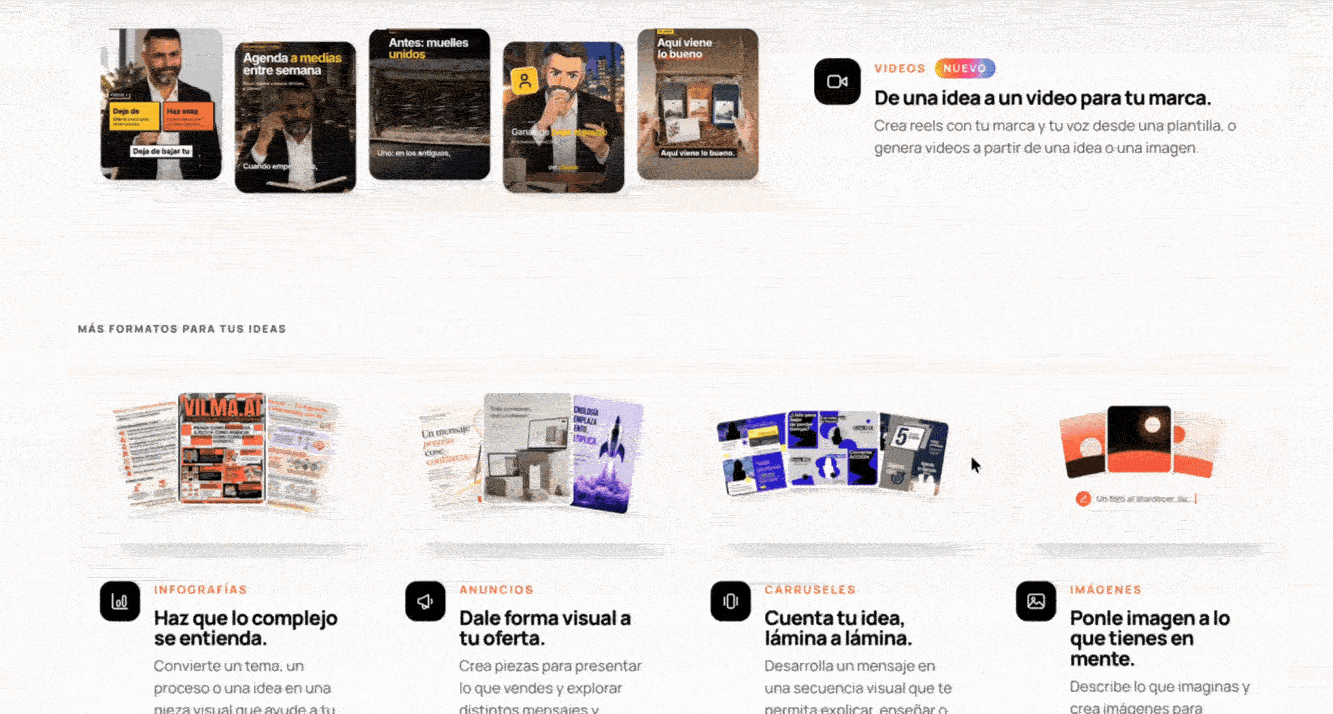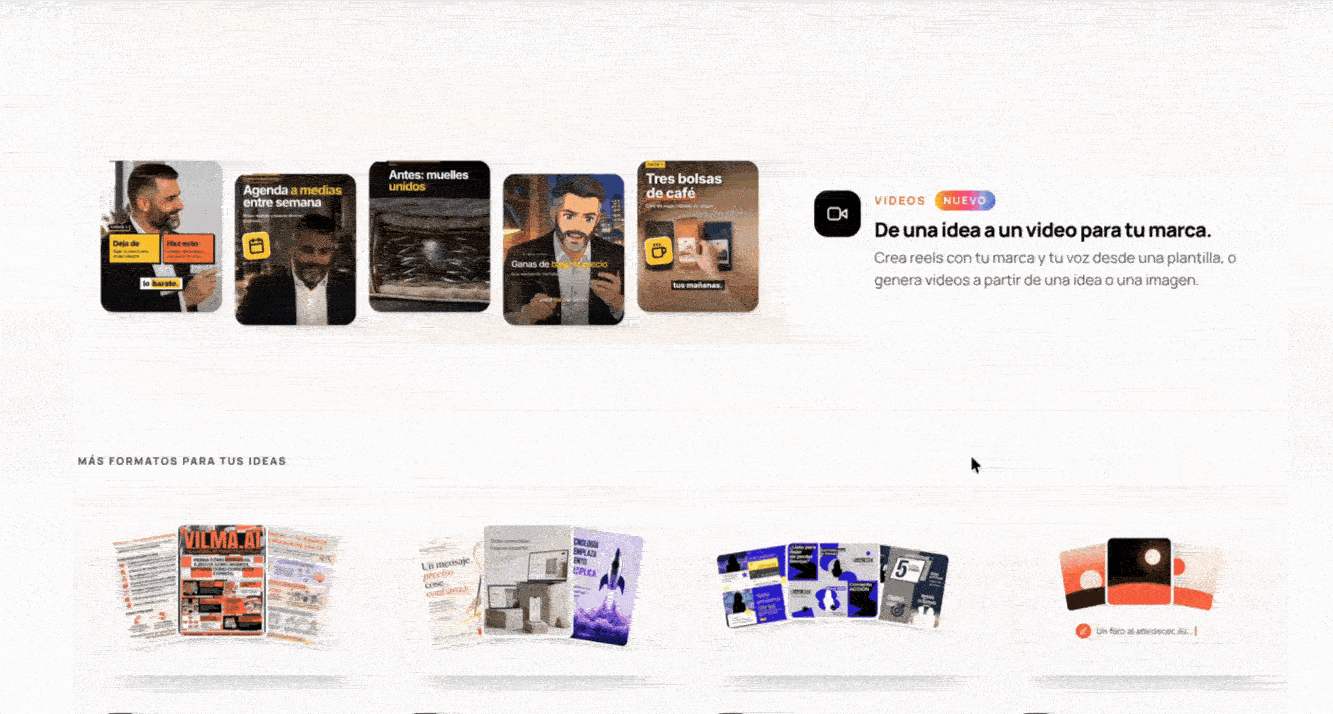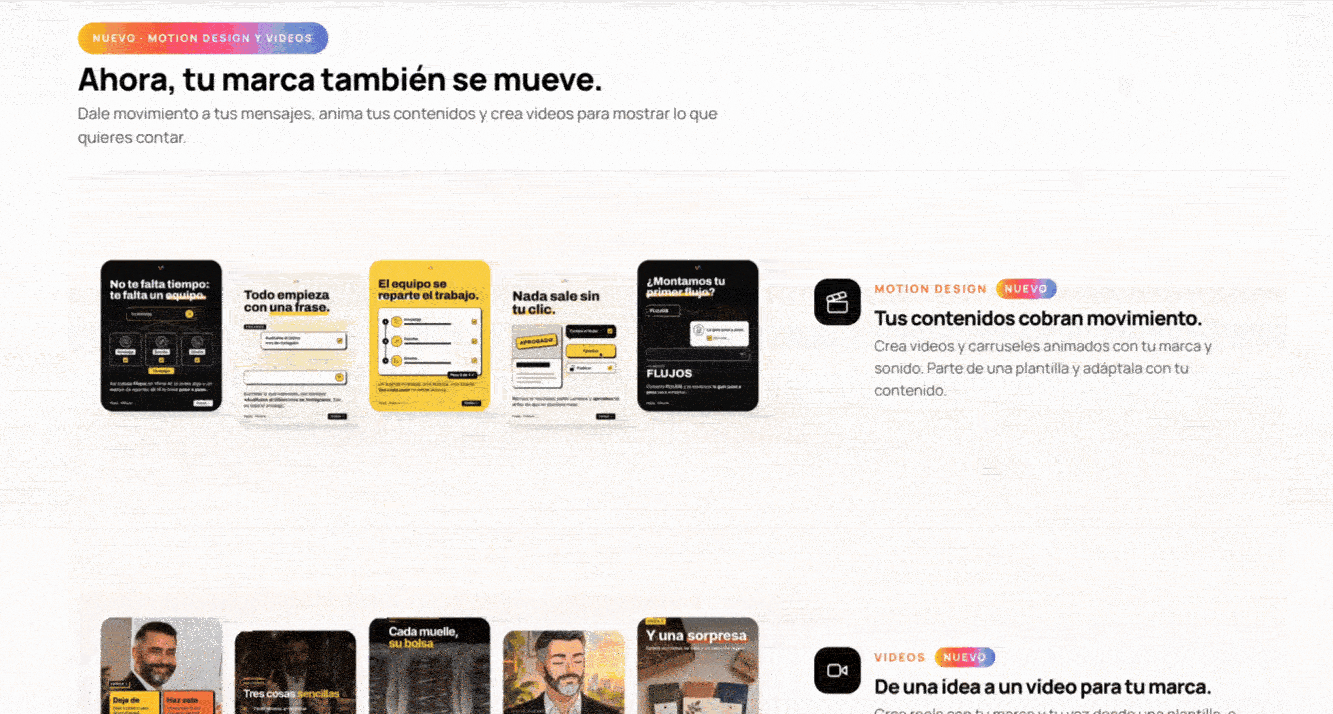
Vilma.ai también se conecta con herramientas que el equipo ya usa, como Gmail, Instagram, Meta Ads, Google, Slack y LinkedIn, para ejecutar tareas sin salir del chat.
De acuerdo a su cofundadora, Vilma Núñez, hoy el equipo mínimo para hacer marketing con IA se compone de cinco agentes:
- Estratega que analiza dónde está el negocio y diseña la estrategia según sus objetivos.
- Copywriter que escribe con el tono de la marca y comunica el valor-
- Diseño creativo que produce piezas visuales alineadas con la identidad.
- Agente de publicidad que analiza qué anuncios funcionan y cómo estructurar campañas.
- Agente de redes sociales que revisa qué publicaciones se comparten, guardan y comentan.

Vilma Núñez aclara que no se trata de tener cinco agentes perfectos desde el primer día, porque debes entender que la configuración de cada uno toma tiempo, y en la experiencia de su equipo de capacitación suele tardar entre seis y doce semanas.
Por eso su recomendación es una meta realista: “Crear un agente o un flujo por semana. En un año, son 52. Es como ver tres capítulos de una serie a la semana: constante, sin agobios y con resultados acumulados“.
Cómo empezar: Guía paso a paso para implementar agentes
Google Cloud recomienda comenzar con un sistema de un solo agente y perfeccionar su lógica, sus instrucciones y las definiciones de sus herramientas antes de añadir componentes más complejos.
Resultado esperado: Desplegar una primera automatización agéntica funcional, segura y controlada.
Requisitos previos: Mapeo de procesos internos, credenciales de API con permisos restringidos y un canal de comunicación de pruebas.
- Elige un proceso repetitivo y medible: Selecciona una tarea delimitada como clasificar solicitudes de soporte, preparar reportes semanales o revisar pedidos.
- Limita herramientas y datos: Otorga al agente acceso exclusivo a los datos necesarios para su tarea concreta.
Error a evitar: Dar acceso root o credenciales globales en la etapa inicial. - Define puntos de aprobación humana: Establece barreras donde el agente requiera confirmación explícita para acciones de alto impacto.
- Registra cada acción: Implementa un sistema de logs que capture los ciclos ReAct para detectar desviaciones.
- Compara contra el proceso manual: Mide tiempos, costos y tasa de error frente a la ejecución humana antes de ampliar el alcance.
- Evalúa si necesitas un super-agente: Transiciona a una arquitectura de enrutamiento y supervisión continua cuando tengas múltiples tareas en paralelo y eventos en varios canales.
Glosario
- Agente de IA: sistema que planifica, usa herramientas y ejecuta acciones para cumplir un objetivo.
- Agentwashing: presentar como agente un asistente que depende de la intervención humana.
- Arnés (harness): programa que coordina al modelo, le entrega información y ejecuta sus herramientas.
- Batching o procesamiento por lotes: juntar varios eventos y procesarlos en una sola llamada al modelo.
- Disparador (trigger): evento del entorno que puede activar al agente, como un mensaje o una alerta.
- Hilo (thread): secuencia de eventos relacionados, como una discusión de código o un tema de chat.
- Inline y Spill: colocar en la ventana de contexto lo que se necesitará pronto y dejar fuera lo extenso.
- Router o enrutador: sesión central que atiende a las personas y asigna trabajo.
- Super-agente: entidad continua que conserva contexto, atiende varias tareas en paralelo y reacciona a su entorno.
- Trabajador (worker): sesión aislada que ejecuta una tarea concreta.
- Watchdog: proceso externo que vigila el progreso y la salud del sistema.
-
Preguntas frecuentes sobre un super-agente de IA
¿Qué es un super-agente?
Es un agente de IA concebido como una entidad continua que conserva contexto entre sesiones, atiende varias tareas en paralelo y reacciona a eventos de su entorno de trabajo. El término lo popularizó el equipo de DeepSeek Harness y todavía no es un estándar.
¿En qué se diferencia un agente de IA de un chatbot?
Un chatbot responde mensajes. Un agente planifica, usa herramientas y ejecuta acciones para cumplir un objetivo, según la definición de IBM.
¿Un agente de IA puede trabajar sin supervisión humana?
Puede operar sin intervención continua, pero requiere objetivos y reglas definidos por personas. Para acciones de alto impacto, IBM recomienda aprobación humana.
¿Por qué separar el cerebro, las manos y la sesión?
Porque cada componente puede fallar, actualizarse o reemplazarse por separado. Según Anthropic, este diseño mejora la recuperación ante fallos y reduce la latencia en su servicio gestionado.
¿Qué pasa con mis datos y credenciales?
Depende del diseño. Las buenas prácticas incluyen que el entorno de ejecución no tenga acceso directo a las credenciales, que estas se guarden en una bóveda externa y que cada acción quede registrada.
¿Cuándo conviene un super-agente?
Cuando hay muchas tareas en paralelo, eventos continuos en varios canales y necesidad de conservar contexto durante semanas. Para procesos aislados, un agente bien configurado suele bastar.
Agentes de IA autónomos: Evolución y super-agente
La evolución de la inteligencia artificial depende de los modelos, pero también de la arquitectura que los rodea: cómo recuerdan, cómo reciben eventos, cómo se recuperan de fallos y cómo protegen lo que tocan.
El super-agente propone que el agente deje de ser una caja de texto a la que se escribe, para convertirse en un colaborador que sigue trabajando cuando nadie lo mira.
Vilma Núñez, cofundadora de Vilma.ai, pone el énfasis en otra parte de esa ecuación: el criterio humano.
En sus palabras, el secreto de la IA no es ningún secreto: es criterio, saber distinguir qué está bien y qué no. La tecnología ofrece la capacidad de ejecutar; pero la decisión sobre qué ejecutar y cómo sigue siendo de las personas.
Si quieres explorar cómo aplicar agentes de IA en tu operación, conoce más sobre Vilma.ai.
Los contenidos del equipo de Vilma Núñez, PhD, se construyen con investigaciones y el material de ORIGEN de sus conferencias, clases, pódcasts, escritos y entrenamientos.
Compartir en: